Markdown のノートから作る、CMS のない個人サイトの構成
tomitaku.net を作り直しました。私が気になった言葉を集めた個人用の百科事典と、過去のブログ記事を、ひとつのサイトにまとめています。
CMS は使っていません。原稿はすべて Markdown ファイルで、更新は Git への push だけ、実装と執筆の大部分は AI(Claude Code)が担っています。この記事では、その構成と背景にある考え方を整理しておきます。
全体の構成
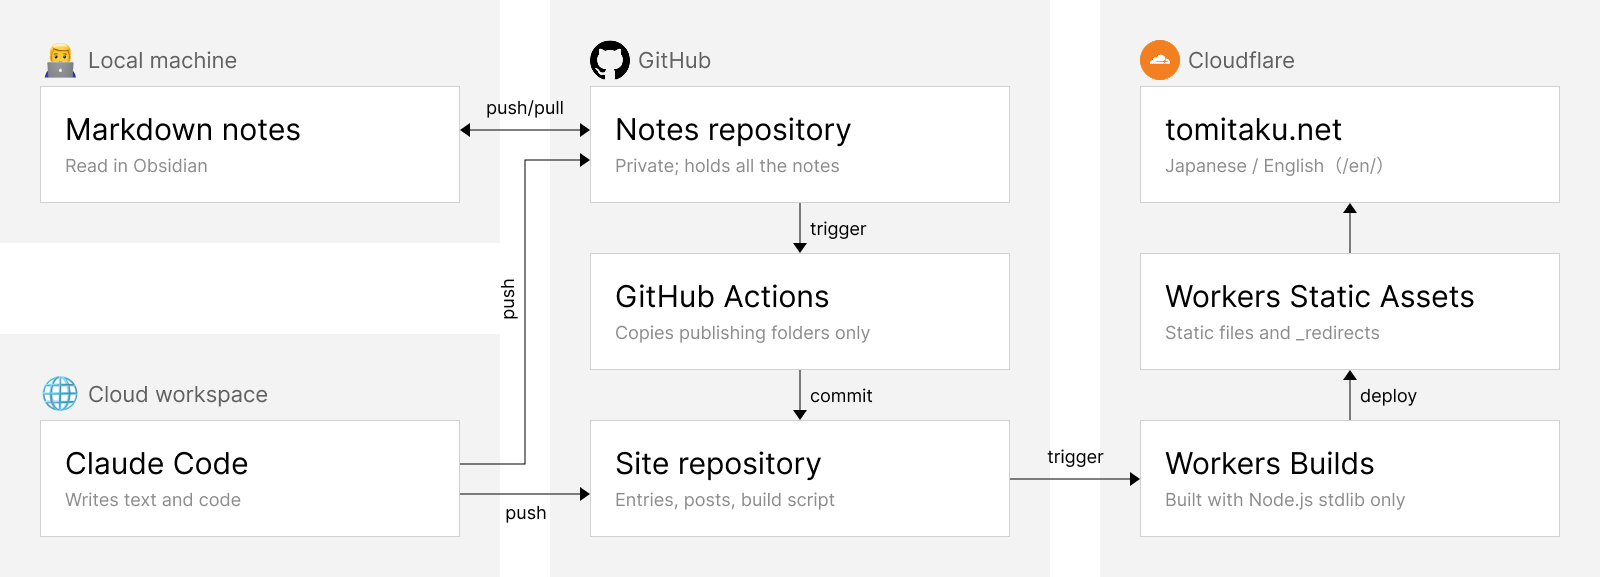
- 原稿:百科事典の項目は非公開のノート用リポジトリ、ブログ記事はサイト用リポジトリに、Markdown で置く
- 公開範囲の抽出:GitHub Actions が、公開用のフォルダの項目だけをサイト用リポジトリに写す
- ビルド:Node.js の標準モジュールだけで書いた、このサイト専用の生成スクリプト
- 配信:Cloudflare Workers Builds でビルドし、Workers Static Assets で配信
配信しているのは静的なファイルだけで、Worker のスクリプトもデータベースもありません。リダイレクトは、ビルド時に書き出した _redirects ファイルを Cloudflare が読んで301を返す、標準の仕組みを使っています。索引の絞り込みなど、ページ上の動きはブラウザ側の JavaScript です。
原稿は Markdown
百科事典の項目の原稿は、Markdown のノートです。書くのは主に Claude Code で、手元ではなくクラウドの作業環境でリポジトリをクローンして書き、push しています。私は手元に取り込んだノートを Obsidian で読んで確認し、気になったところは自分で直します。Obsidian はビューワーとして使っているだけで、データはただのテキストファイルです。ブログ記事の原稿だけは、ノートではなくサイト用リポジトリに直接置いています。
ノートには仕事のメモや個人的な記録も混ざっているので、ノートとサイトのリポジトリを分けました。ノート用リポジトリの公開用フォルダ(日本語と英語の2つ)に変更が push されると GitHub Actions が動き、その中の項目だけをサイト用リポジトリにコミットします。サイトのビルドは非公開のノートに触れないので、ビルドの設定を誤っても、公開用フォルダの外にあるノートが出ていくことはありません。
ビルドと配信
生成スクリプトは400行ほどのこのサイト専用のもので、Node.js の標準モジュールだけで書いています。Markdown の変換も汎用のライブラリは使わず、自分が使う記法(見出し、リスト、リンク、画像、引用、コード、脚注など)だけを扱う簡易的なものです。ビルドに使う npm パッケージはありません(デプロイには Cloudflare の CLI である wrangler を使います)。個人サイトは何年も手を入れない時期が出てくるものなので、そのあいだに依存ライブラリの更新や脆弱性対応が積み重なり、久しぶりの更新がビルド環境の復旧から始まる、という事態を避けたかったからです。
ビルドでは、項目ページと索引に加えて、その項目名に触れている項目の一覧、文字2-gram の TF-IDF とコサイン類似度で求めた関連項目、まだ項目のない言葉のページ、リダイレクトの設定(_redirects)、英語版(/en/)と hreflang の指定を生成しています。
サイト用リポジトリの main ブランチに push すると、Workers Builds がビルドからデプロイまでを行います。過去のブログ記事は WordPress の REST API で書き出して Markdown に変換しました。記事の番号は WordPress 時代のものをそのまま使い、旧 URL の /blog/archives/<番号> からは301でリダイレクトしています。
管理画面の代わりに AI に頼む
管理画面はありません。項目の追加も記事の修正も、テキストファイルを編集して push するという同じ操作です。
その作業の大部分を Claude Code に任せています。私は自分ではコードを書かないので、生成スクリプトも、GitHub Actions のワークフローも、WordPress からの移行も、Claude Code が書いたものです。私の役割は、どういうサイトにしたいかを言語化し、出てきたものを確認して判断することです。
百科事典の項目も、Claude と一緒に調べて書いています。執筆の手順は Claude Code のスキル(作業手順を記述したファイル)にまとめてあり、参照した資料を明記すること、裏付けの取れなかった記述は「要確認」として残すこと、英訳も同時に作ることなどを決めています。
時系列で並べないトップページ
一般的なブログのトップページは、新着順の一覧です。このサイトのトップには、一覧も検索窓もありません。いくつかの項目を順にたどる一段落の文章が表示され、読み終えると、その中で通った項目へのリンクが並びます。
この設計は、デジタルガーデンという考え方を下敷きにしています。マイク・コールフィールド2は2015年の講演で、SNS やブログのように情報が時系列に流れていくウェブを「stream(流れ)」、ウィキのように情報どうしを結びつけ、繰り返し手を入れていくウェブを「garden(庭)」と呼んで対比しました。デジタルガーデンは、後者の考え方で個人のサイトを作ろうとするものです。
新着順の一覧では、古い項目ほど埋もれていきます。項目どうしのつながりを入口にすれば、いつ書いた項目でも同じように読まれます。時系列の一覧は、索引のページに移しました。
トップの文章は、Claude が項目を読んで書き、私が推敲したものです。アクセスのたびに生成はしていません。費用と待ち時間がかかるうえに、誰も確認していない文章がサイトの顔になってしまうからです。
個人用の百科事典をテキストで持つ意味
項目に並んでいるのは、円筒分水工、PEBCAK、ダズル迷彩といった、私が個人的に気になった言葉です。意味を知りたいだけなら Wikipedia で十分ですが、何を選び、何と何を結びつけたかという記録には、私の関心の輪郭が表れます。
その記録がテキストファイルであることに意味があります。Claude Code をこのノートの上で動かし、そう指示しておけば、AI は必要に応じてノートを検索して読みながら応答します。RAG のように使える私専用の外部記憶で、趣味や関心、ものの見方を毎回説明しなくても、それを前提にした対話ができます。
公開しているサイトは、その知識ベースの一部を外から読めるようにしたものにすぎません。積極的に宣伝するつもりはありませんが、辞書が増えるにつれて、このサイトも少しずつ育っていきます。